Publications
-
 Deformation-based In-Context Learning for Point Cloud Understanding
Chengxing Lin, Jinhong Deng, Yinjie Lei, Wen Li
-
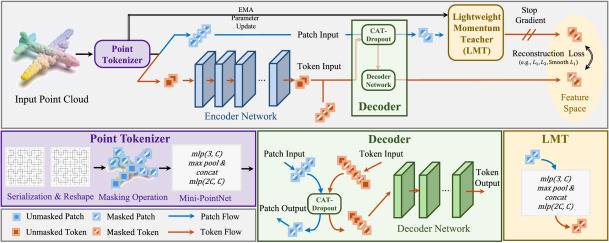 Resource-Efficient Masked Autoencoding Framework for 3D Representation Learning
Jian Zhu, Jiale Zhao, Chengxing Lin, Luan Lyu, Ruichu Cai, Xiaohua Ren, Enhua Wu
-
 PatchMixing Masked Autoencoders for 3D Point Cloud Self-Supervised Learning
Chengxing Lin, Wenju Xu, Jian Zhu, Yongwei Nie, Ruichu Cai, Xuemiao Xu
Manuscripts
- TETRIS: Self-Supervised Task Representation Learning for Point In-Context Learning
submitting
- NavTTT: Adaptive Parametric Memory via Hierarchical Test-Time Training for Vision-and-Language Navigation
submitting
- GuidedNav: Shaping Vision-Language Navigation Representations through Pre-Action Attention and Spatial Guidance
submitting